IA et automatisation · DevOps · Cybersécurité · 17 octobre 2026
Vibe coding, oui, mais avec une CI sécurisée
J'utilise Claude Code sur tous mes projets de développement. La plateforme e-commerce d'Imprime Ton Texstyle (personnalisation textile pour les professionnels) en fait partie : 407 commits depuis le 29 décembre 2025, une grande partie du code écrite par l'IA. Le code généré compile presque toujours. Il n'est pas toujours juste, et c'est ce qui organise ma façon de travailler : chaque proposition de l'IA est relue, testée ou contestée avant d'entrer dans le projet.
Les spécifications avant le code
Je ne commence pas à coder sans spécifications fonctionnelles écrites et relues. Elles décrivent qui utilise l'application, ce qu'elle fait, ce qu'elle ne fait pas, et les contraintes : hébergement, données personnelles, budget.
Pour une application neuve, je les rédige avec l'IA. Elle pose des questions sur les cas que je n'ai pas décrits (un client qui annule après validation, un produit sans stock), je réponds et je tranche.
Pour du code existant, la méthode est différente.
Reprendre du code existant
Sur un projet repris, je demande d'abord à l'IA de lire le code, sans rien modifier. Elle le parcourt module par module et rédige ce qu'elle observe : les règles métier, les statuts possibles d'une commande, les calculs de prix, les droits de chaque rôle. Chaque point doit citer le fichier et la ligne d'où il vient. Ce qu'elle n'a pas compris va dans une liste séparée, plutôt que d'être comblé par une supposition.
Ce document sert de documentation au projet. Je le vérifie en utilisant l'application.
La même lecture aide à décider de ce qu'il ne faut pas réécrire. Le configurateur produit d'Imprime Ton Texstyle tient dans un fichier d'environ 2 300 lignes. Il est gros, mais il fonctionne, et la bibliothèque de dessin sur laquelle il repose impose de toute façon beaucoup d'écouteurs d'événements. La décision est notée dans la mémoire du projet : pas de réécriture, du refactoring par petites étapes. Sans cette note, une session suivante peut très bien proposer de tout refaire.
Choisir la stack
Je décris les contraintes à l'IA et je lui demande deux ou trois options, avec les défauts de chacune. Ensuite je pose des questions sur chaque choix (cette version est-elle maintenue, que coûte un changement d'hébergeur de fichiers dans un an) et je vérifie les réponses dans la documentation officielle.
Cette vérification compte parce qu'un modèle a une date limite de connaissances. Next.js 16, sur lequel tourne ce site, a modifié des API que l'IA pense connaître. Next.js ajoute lui-même un avertissement dans le fichier d'instructions destiné aux agents (« This is NOT the Next.js you know ») et leur demande de lire la documentation livrée avec la version installée.
Le socle du projet
La structure se décide au début. Les premiers commits d'Imprime Ton Texstyle ne contiennent pas d'écran : une feuille de route, le schéma complet de la base de données, un service d'envoi d'e-mails indépendant du fournisseur, une couche d'accès aux fichiers compatible S3. Cette dernière permet d'utiliser un stockage en local et un autre en production sans que le code métier change.
Chaque projet a aussi un fichier de mémoire que l'IA lit au début de chaque session. Il contient la stack, l'organisation des dossiers, les décisions prises avec leur raison, les commandes utiles et les pièges déjà rencontrés. Je le mets à jour en fin de session. Sans lui, chaque nouvelle session repart de zéro et peut introduire une convention différente de la précédente.
Sprints et intégration continue
Je travaille par sprints. Chaque sprint correspond à un lot fonctionnel testable en entier : la spécification du lot, le code, ma relecture, les tests, la recette, puis la fusion dans la branche principale. Cyber DPE, l'outil de diagnostic de ce site, a été découpé en 9 sprints avant d'écrire la première ligne.
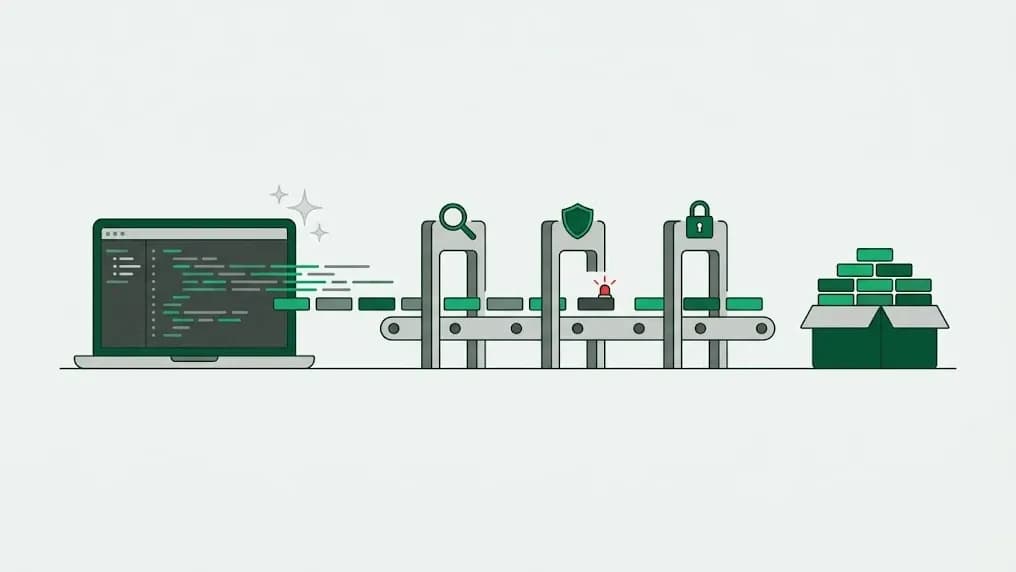
La CI d'Imprime Ton Texstyle tourne sur GitLab, en quatre étapes :
Étape | Contrôles | Bloquant |
|---|---|---|
verify | lint, typage, tests unitaires, contrôle des modifications du schéma de base | oui |
verify | recherche de secrets dans le code et l'historique git (gitleaks) | oui |
verify | failles connues des dépendances, configuration du Dockerfile (Trivy) | oui, pour les niveaux HIGH et CRITICAL |
build | construction de l'image Docker, une seule fois |
|
scan | analyse de l'image par Trivy, inventaire des composants (SBOM) envoyé à Dependency-Track | oui, pour les paquets système HIGH, CRITICAL ou en fin de vie |
deploy | préproduction automatique, production déclenchée à la main |
|
Les images des outils de la CI sont épinglées par leur empreinte sha256 et pas seulement par leur numéro de version, ce qui empêche une image modifiée sous le même numéro d'entrer dans la chaîne. La production reçoit l'image déjà testée en préproduction, sans reconstruction. L'image finale ne contient que les dépendances de production.
Exceptions de sécurité avec date d'expiration
Il arrive qu'une faille signalée par Trivy ne soit pas corrigeable tout de suite : pas de version corrigée, ou une montée de version majeure à préparer. Dans ce cas, j'ajoute une exception dans un fichier dédié. Chaque exception doit contenir une justification et une date d'expiration, et la CI échoue si l'une des deux manque. Une exception ressemble à ceci (exemple fictif) :
- id: CVE-AAAA-NNNNN
  paths: ["package-lock.json"]
  statement: >-
    bibliotheque-x 1.2.3, faille dans la fonction d'export.
    Le code n'appelle pas cette fonction : non exploitable.
    Correction prévue avec la version 2.
  expired_at: 2027-01-31
À la date d'expiration, Trivy signale de nouveau la faille et la CI bloque. Il faut alors corriger, ou rédiger une nouvelle justification.
Tests ciblés et revue de code
Je ne cherche pas un taux de couverture. J'écris des tests pour ce qui coûte cher en cas d'erreur : les calculs de prix, les droits d'accès, les imports de données, les cas limites qu'on ne voit pas en utilisant l'interface. Imprime Ton Texstyle a 78 fichiers de tests (Vitest). Cyber DPE a 294 tests unitaires et un parcours complet testé dans un navigateur (Playwright).
La recette se fait à la main sur la préproduction, en suivant le parcours client du début à la fin.
Je relis le code moi-même, en priorité tout ce qui touche à l'authentification, aux prix et aux données personnelles. Je fais aussi faire des revues complètes par l'IA, avec un cadre précis. Celle du 9 septembre 2026 sur Imprime Ton Texstyle a été menée en lecture seule, en sept passes séparées : authentification, autorisation des API, envois de fichiers et imports, XSS et RGPD, accès concurrents, logique métier, qualité du code. Chaque constat devait être vérifié dans le code avec sa référence, et les points non vérifiés étaient listés à part. La revue a relevé entre autres une même règle de calcul codée à plusieurs endroits, qui avait divergé avec le temps. Les correctifs ont été livrés en quatre lots entre le 9 et le 11 septembre.
Supprimer le code mort
Avec l'IA, les fichiers s'accumulent vite : scripts de test, outils de débogage, composants remplacés. Le 8 septembre 2026, le dossier scripts/ d'Imprime Ton Texstyle contenait 123 fichiers. L'IA a produit un inventaire : pour chaque fichier, ce qui l'appelait (Dockerfile, package.json, code, documentation), la date du dernier commit, et s'il faisait doublon avec un test existant. Le document précisait qu'aucune suppression n'avait été faite et qu'il servait de base à une relecture humaine.
Après relecture, 73 scripts ont été supprimés et 14 archivés. Lors d'autres passes, j'ai retiré une API externe que personne n'utilisait (aucune clé créée, aucun appel enregistré) et environ 550 lignes inutilisées du configurateur.
Mises à jour
Je mets à jour les dépendances en continu. Trivy contrôle chaque build. Dependency-Track réanalyse les inventaires déjà envoyés quand une nouvelle faille est publiée, ce qui couvre aussi une version en production qui n'a pas été redéployée depuis plusieurs semaines. Les montées de version majeures repoussées ont une date limite, celle des exceptions qui les accompagnent.